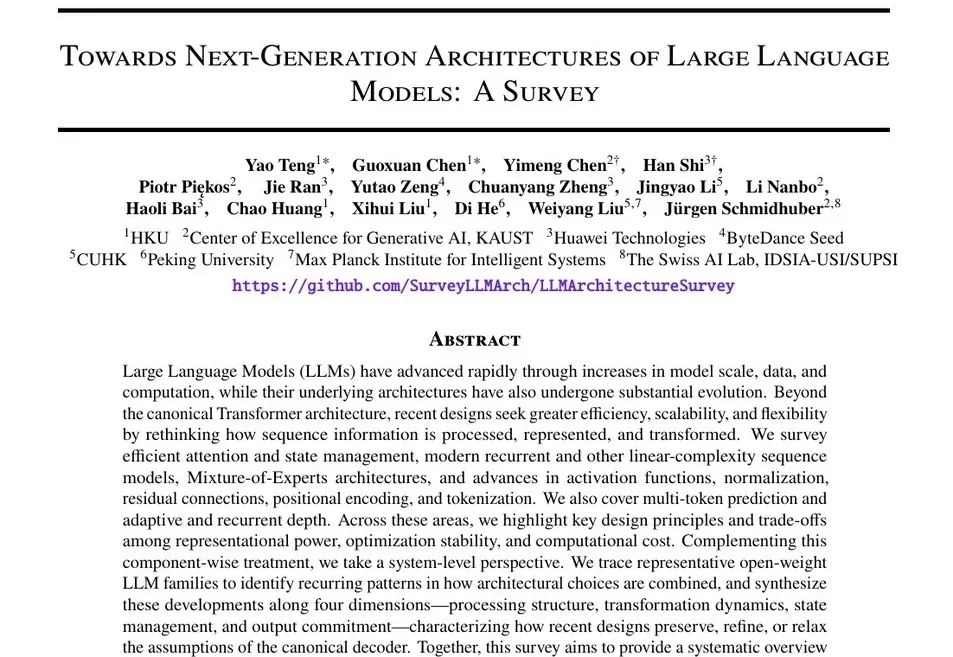
下一代语言模型架构走向何方?LSTM之父领衔,KAUST、港大、华为等共同发布领域全面综述
下一代语言模型架构走向何方?LSTM之父领衔,KAUST、港大、华为等共同发布领域全面综述Scaling up 是大模型的标志,也引领了近几年语言模型技术的飞跃。然而实际上,大语言模型架构,作为其最本质的计算基础,也在近年来持续发展。
来自主题: AI技术研报
7116 点击 2026-11-12 10:21

 搜索
Scaling up 是大模型的标志,也引领了近几年语言模型技术的飞跃。然而实际上,大语言模型架构,作为其最本质的计算基础,也在近年来持续发展。
事关路由LLM(Routing LLM),一项截至目前最全面的研究,来了——
近年来, Scaling Up 指导下的 AI 基础模型取得了多项突破。从早期的 AlexNet、BERT 到如今的 GPT-4,模型规模从数百万参数扩展到数千亿参数,显著提升了 AI 的语言理解和生成等能力。然而,随着模型规模的不断扩大,AI 基础模型的发展也面临瓶颈:高质量数据的获取和处理成本越来越高,单纯依靠 Scaling Up 已难以持续推动 AI 基础模型的进步。
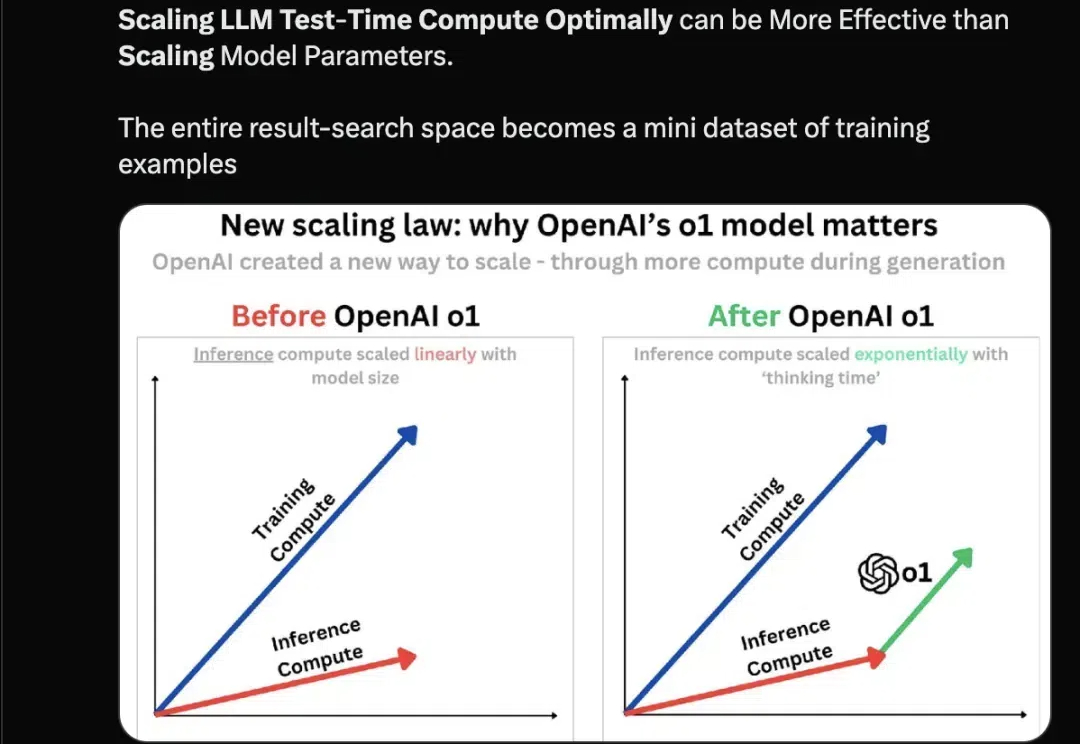
随着 o1、o1 Pro 和 o3 的成功发布,我们明显看到,推理所需的时间和计算资源逐步上升。可以说,o1 的最大贡献在于它揭示了提升模型效果的另一种途径:在推理过程中,通过优化计算资源的配置,可能比单纯扩展模型参数更为高效。
自回归训练方式已经成为了大语言模型(LLMs)训练的标准模式, 今天介绍一篇来自阿联酋世界第一所人工智能大学MBZUAI的VILA实验室和CMU计算机系合作的论文,题为《FBI-LLM: Scaling Up Fully Binarized LLMs from Scratch via Autoregressive Distillation》